
7.1만 건의 메이플 아이템을 '느낌과 외형'으로 찾다: 로컬 VLM 시각 구조화와 Int8 하이브리드 임베딩 검색 아키텍처
아이템의 정확한 이름을 몰라도 '분홍색 리본 구두', '보라색 거대한 악마 날개'처럼 직관적인 외형·색상·분위기 단어로 71,235건의 자산을 실시간 검색하는 2-Stage 로컬 Vision LLM + BGE-M3 텍스트 임베딩 및 Int8 양자화 하이브리드 검색 엔진의 설계 원리, 한계점, 추론 비용 절감 기법을 공유합니다.
메이플스토리에는 수십 년간 누적된 장비, 치장 아이템, 의자, 라이딩, 데미지 스킨, 칭호, 훈장, 몬스터, 펫 등 방대한 시각 자산이 존재합니다. 코디(룩덕)를 맞추거나 원하는 컨셉의 아이템을 찾을 때 모험가들이 가장 자주 겪는 어려움은 "머릿속에 떠오르는 외형은 뚜렷한데, 아이템의 공식 이름에는 그 단어가 전혀 들어있지 않다"는 점입니다.
예를 들어 "분홍색 리본이 달린 구두"나 "보라색 거대한 악마 날개 망토", "초승달에 앉아 있는 의자"를 찾고 싶어도, 실제 아이템 이름이 시적인 은유나 이벤트 고유 명사로 지어져 있다면 기존의 단순 문자열 일치(이름 검색)만으로는 절대 찾을 수 없습니다. 너공마 아카이브는 이 문제를 해결하기 위해 71,235건의 아카이브 자산을 로컬 멀티모달 AI로 시각 구조화하고, 이를 1024차원 텍스트 임베딩 및 한국어 복합어 분해 엔진과 결합한 하이브리드 시맨틱 검색 시스템을 구축했습니다.
1. 왜 이미지를 바로 임베딩(CLIP)하지 않고 '2-Stage 시각→텍스트 임베딩'으로 설계했는가?
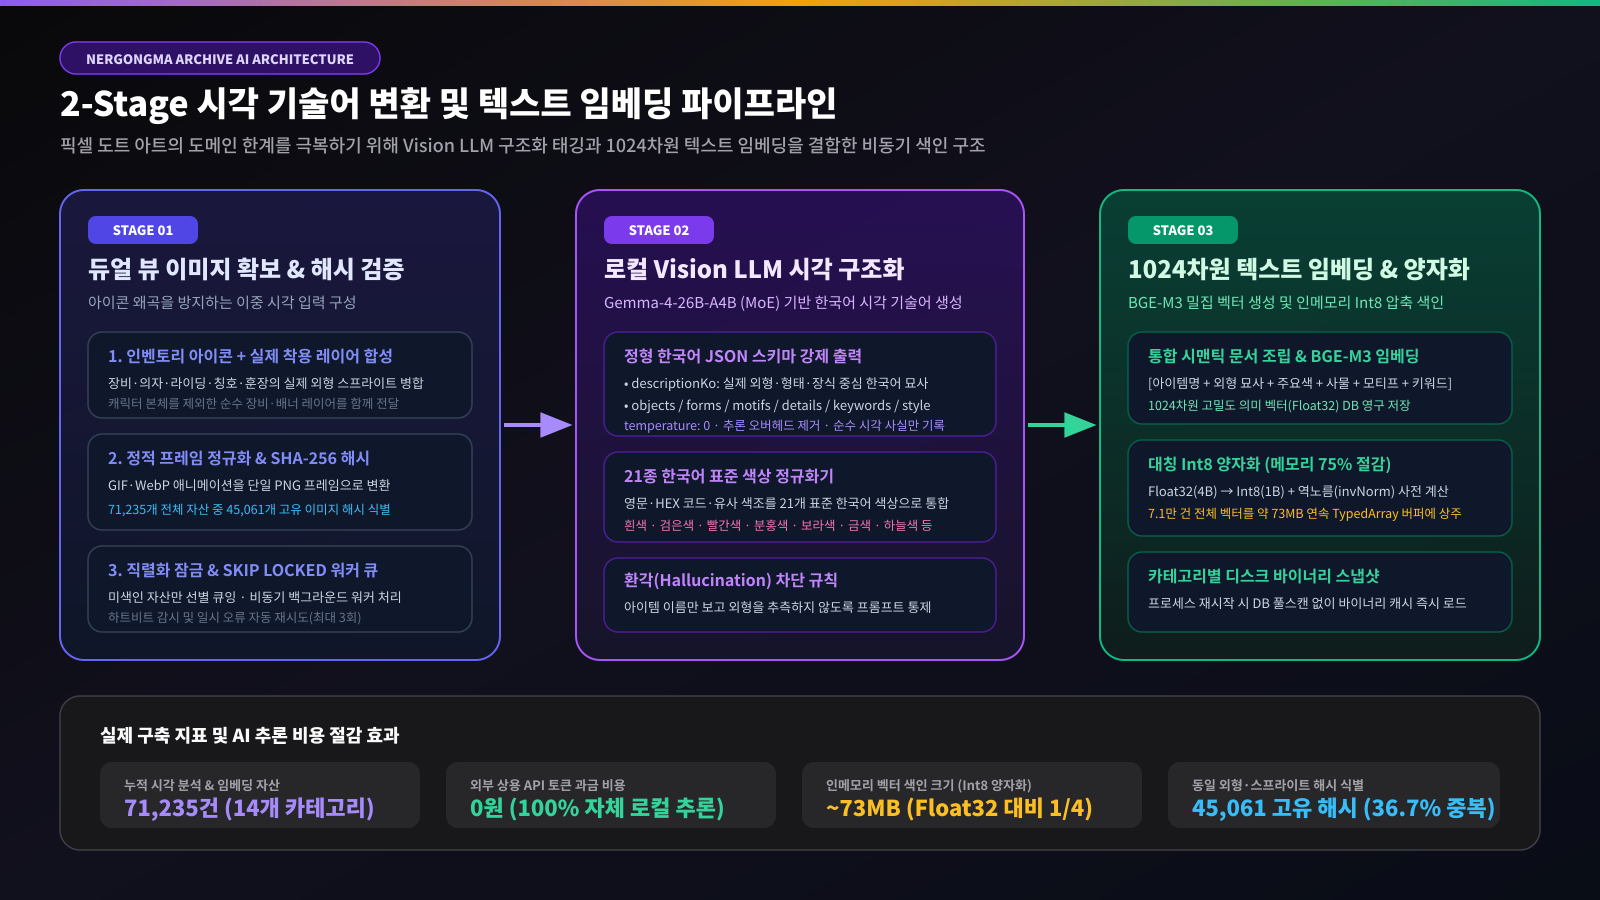
이미지 검색 시스템을 설계할 때 흔히 가장 먼저 떠올리는 방식은 CLIP이나 SigLIP 같은 멀티모달 이미지-텍스트 공유 임베딩 모델에 아이템 이미지를 직접 넣어 벡터화하는 것입니다. 하지만 메이플스토리 아카이브 환경에서는 단일 이미지 임베딩 방식 대신 [Stage 1: 로컬 Vision LLM을 통한 한국어 시각 기술어 생성] → [Stage 2: 다국어 텍스트 임베딩(BGE-M3) 벡터화]의 2단계 파이프라인을 채택했습니다. 여기에는 세 가지 결정적인 기술적 이유가 있습니다.
- 2D 픽셀 도트 아트의 도메인 갭(Domain Gap) 극복: 범용 이미지 임베딩 모델은 실사 사진과 일반 일러스트 위주로 학습되어 있어, 30×30 픽셀 내외의 저해상도 도트 스프라이트나 투명 배경 아이템에서 세부 장식(안대, 볼터치, 리본, 오라, 무기 이펙트 등)의 의미를 정확히 벡터 공간에 투영하지 못합니다. 반면 26B 규모의 Vision LLM은 도트 그래픽의 맥락과 조형 요소를 훨씬 정밀하게 판독합니다.
- 한국어 게임 도메인 어휘와의 정밀한 정렬: 모험가들은 "한벌옷", "망토", "백팩", "헤어핀", "초승달", "창백한", "금빛"처럼 한국어 고유 표현과 복식 어휘로 검색합니다. Vision LLM이 먼저 한국어 표준 어휘로 시각 특징을 풀어써 주고, 한국어 문장 표현력이 뛰어난 BGE-M3(1024차원)가 이를 텍스트 공간에서 임베딩하면 질의어와 문서 간의 모달리티 격차(Modality Gap)가 사라집니다.
- 설명 가능성(Explainability)과 결정론적 필터링 결합: 블랙박스 이미지 벡터만 저장하면 왜 특정 아이템이 검색되었는지 설명하거나 오류를 교정하기 어렵습니다. 중간 산출물로 정형화된 한국어 JSON 태그(색상, 사물, 형태, 무늬, 외형 묘사)를 확보하면 벡터 유사도 검색과 SQL 키워드·색상 필터링을 동시에 결합할 수 있습니다.
2. 오프라인 분석 및 임베딩 구축 파이프라인 상세 구조
2-1. 인벤토리 아이콘의 한계를 보완하는 '듀얼 뷰(Dual-View)' 시각 입력
메이플스토리의 많은 아이템은 인벤토리 아이콘과 실제 착용·탑승 시의 외형이 크게 다릅니다. 예를 들어 칭호나 훈장의 인벤토리 아이콘은 작은 메달 모양이지만, 실제 모험가가 찾고 싶은 외형은 캐릭터 머리 위에 펼쳐지는 화려한 인게임 배너입니다. 장비나 의자·라이딩 역시 아이콘에서는 일부만 확대되어 있거나 접혀 있는 경우가 많습니다.
이를 해결하기 위해 분석 파이프라인은 대상 카테고리에 따라 두 장의 이미지를 동시에 Vision LLM에 입력합니다.
- 장비 아이템(40,695건): 첫 번째 이미지로 인벤토리 아이콘을, 두 번째 이미지로 캐릭터 알몸 본체를 제거한 순수 장비 착용 레이어를 렌더링하여 전달합니다. 캐릭터 피부색이나 기본 헤어가 장비 색상으로 오인되는 현상을 원천 차단합니다.
- 의자(1,542건) 및 라이딩(685건): 인벤토리 아이콘과 함께 실제 인게임 탑승·착석 상태 스프라이트를 함께 전달하여 전체 조형과 배경 구조물을 판독합니다.
- 칭호(427건) 및 훈장(852건): 인벤토리 아이콘과 실제 머리 위 착용 배너 이미지를 함께 전달하여 테두리 장식과 배너 색상을 정확히 기록합니다.
2-2. 로컬 Vision LLM(Gemma-4-26B-A4B)과 21색 표준 정규화기
시각 분석 모델로는 MoE(Mixture-of-Experts) 아키텍처 기반의 Gemma-4-26B-A4B를 자체 로컬 추론 환경에서 구동합니다. 자유 서술형 텍스트 대신 아래의 엄격한 정형 JSON 스키마만 출력하도록 통제합니다.
{
  "primaryColors": ["분홍색", "흰색"],
  "secondaryColors": ["금색"],
  "objects": ["구두", "리본", "보석"],
  "forms": ["둥근 앞코", "낮은 굽"],
  "motifs": ["하트", "날개"],
  "details": ["발목 스트랩", "금빛 테두리 장식"],
  "keywords": ["분홍 구두", "리본 신발", "러블리 슈즈"],
  "style": "발랄하고 아기자기한 동화풍 스타일",
  "descriptionKo": "부드러운 분홍색 바탕에 흰색 레이스와 큰 리본 장식이 달린 구두로, 발목 스트랩 중앙에 작은 금빛 하트 보석이 박혀 있다.",
  "confidence": 0.94
}
특히 색상 표현의 파편화(예: 모델이 때로는 "코랄 핑크", 때로는 "#FF88AA", 때로는 "연분홍빛"으로 출력하는 문제)를 막기 위해, 시스템 프롬프트와 후처리 파서 양단에서 모든 색상을 21가지 한국어 표준 색상(흰색, 검은색, 회색, 은색, 빨간색, 주황색, 노란색, 금색, 초록색, 연두색, 청록색, 하늘색, 파란색, 남색, 보라색, 분홍색, 자주색, 갈색, 베이지색, 황토색, 살구색)으로 정규화합니다. 또한 "아이템 이름만 보고 보이지 않는 외형을 추측하지 말 것"을 강제하여 환각(Hallucination) 태그 생성을 방지합니다.
2-3. BGE-M3 1024차원 텍스트 임베딩과 대칭 Int8 양자화 색인
Vision LLM이 생성한 구조화 데이터는 [아이템명 + 한국어 외형 묘사 + 주요 색상 + 사물 + 모티프 + 키워드] 형태의 밀집 시맨틱 텍스트로 조립된 뒤, 로컬 BGE-M3 임베딩 모델을 거쳐 1024차원 실수 벡터(Float32)로 변환됩니다.
71,235건의 1024차원 Float32 벡터를 매 검색 요청마다 데이터베이스에서 읽어오거나 무거운 외부 벡터 DB 통신을 거치면 응답 지연이 발생합니다. 이를 해결하기 위해 너공마는 대칭 Int8 양자화(Symmetric Int8 Quantization) 기반의 인메모리 파티션 색인을 직접 구현했습니다.
| 구분 | 원본 Float32 벡터 | 대칭 Int8 양자화 색인 (현재 적용) | 설계 효과 |
|---|---|---|---|
| 차원당 크기 | 4 Bytes (32-bit float) | 1 Byte (-127 ~ 127 정수) + 역노름(Float32) | 벡터 메모리 사용량 75% 절감 |
| 71,235건 전체 용량 | 약 291.8 MB (JS 객체 오버헤드 별도) | 약 73.2 MB (연속 TypedArray 버퍼) | 웹 서버 프로세스 메모리에 상주 가능 |
| 유사도 연산 방식 | 부동소수점 곱셈 + 제곱근 나눗셈 | 8-Way 루프 언롤링 정수 내적 × 사전 계산 역노름 | 수만 건 코사인 유사도 계산 수 ms 내 완료 |
| 재시작 복구 | DB 대량 조회 필요 | 카테고리별 디스크 바이너리 스냅샷 즉시 매핑 | 콜드 스타트 시 DB 풀스캔 제로화 |
3. 실시간 하이브리드 검색 엔진과 스코어링 아키텍처
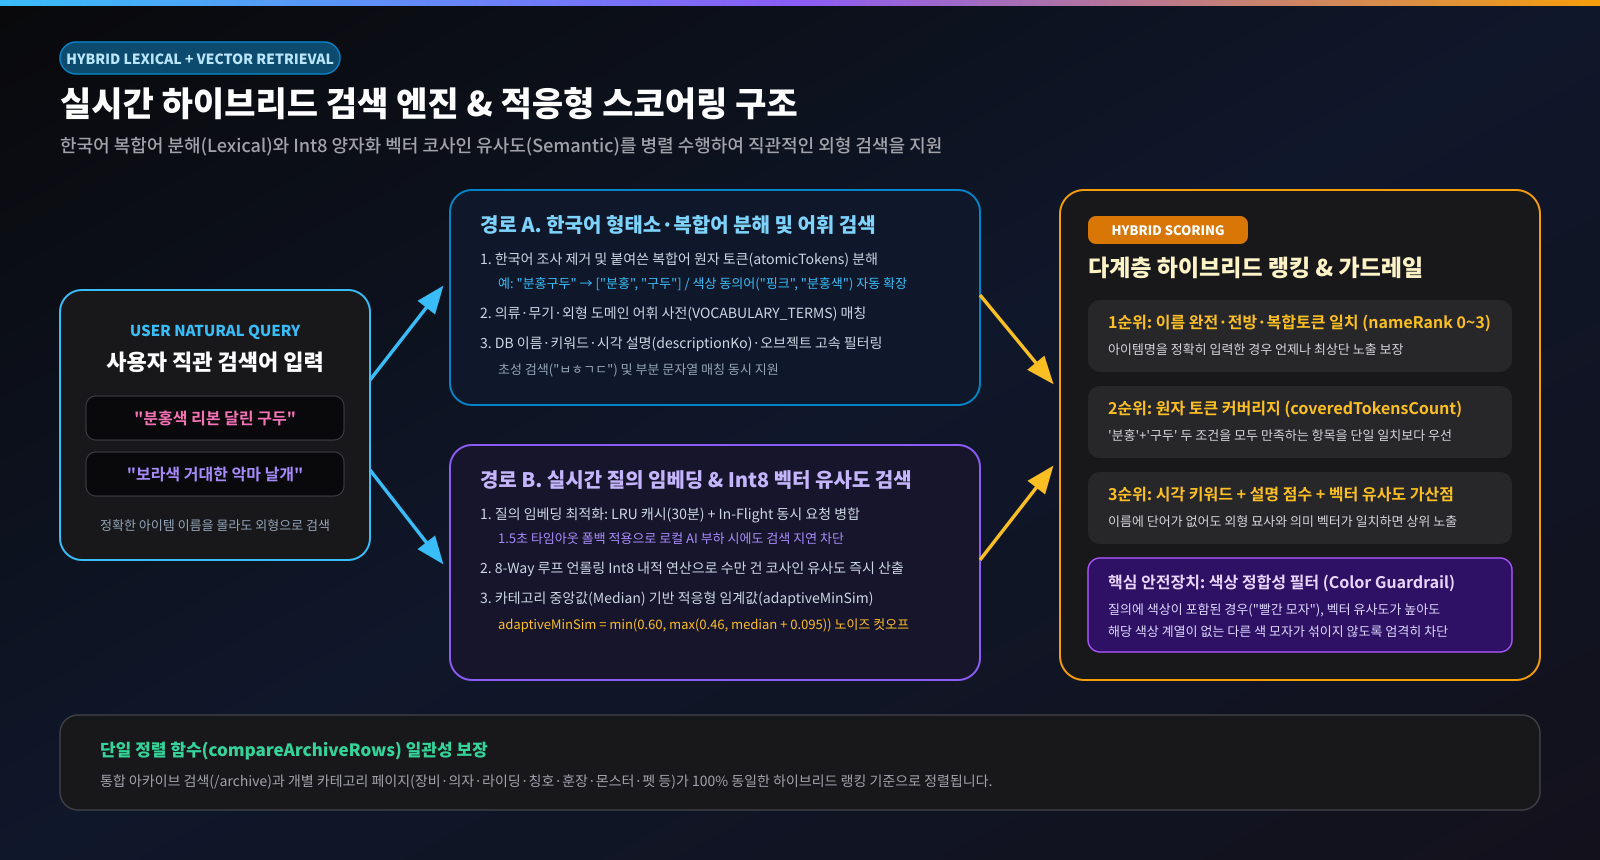
사용자가 검색창에 검색어를 입력하면, 시스템은 단일 검색 방식에 의존하지 않고 어휘 검색(Lexical Retrieval)과 벡터 의미 검색(Semantic Vector Retrieval)을 병렬로 수행한 뒤 다계층 스코어링 함수로 통합합니다.
- 한국어 복합어 원자 토큰 분해기(
decomposeSearchQuery): 모험가들은 공백 없이 "분홍구두", "흰갈색머리", "검은안대"처럼 붙여 검색하는 경우가 많습니다. 자연어 분석기가 한국어 조사를 제거하고, 색상 어간 사전 및 메이플 복식·무기 명사 사전(VOCABULARY_TERMS)을 이용해 복합어를 핵심 의미 단위(atomicTokens: ["분홍", "구두"])로 분해하며 색상 동의어("분홍" ↔ "핑크", "분홍색")를 자동 확장합니다. - 적응형 임계값(Adaptive Similarity Cutoff) 기반 벡터 탐색: 텍스트 임베딩 공간에서는 질의어의 특성에 따라 전체 아이템과의 평균 코사인 유사도 분포가 달라집니다. 고정 임계값 하나만 쓰면 어떤 검색어에서는 결과가 너무 많이 나오고 어떤 검색어에서는 누락됩니다. 이를 방지하기 위해 검색 시점마다 카테고리 내 유사도 중앙값(
medianSimilarity)을 샘플링하여adaptiveMinSim = min(0.60, max(0.46, median + 0.095))공식으로 배경 노이즈 대비 통계적으로 유의미하게 돌출된 상위 시맨틱 후보만 채택합니다. - 색상 정합성 가드레일(
hasRequestedQueryColors): 순수 벡터 유사도 검색의 대표적인 부작용은 "빨간색 별 모자"를 검색했을 때 형태와 모티프(별, 모자)가 매우 유사하다는 이유로 "파란색 별 모자"까지 높은 코사인 유사도를 받아 상위에 섞이는 현상입니다. 너공마 하이브리드 엔진은 질의어에 명시적인 색상 토큰이 포함된 경우, 해당 색상(또는 동의어 계열)이 실제 아이템의 시각 분석 데이터에 존재하는지 교차 검증하여 다른 색상의 아이템이 시맨틱 점수로 끼어드는 것을 엄격히 차단합니다. - 7단계 결정론적 우선순위 정렬(
compareArchiveRows):- 1순위: 정확한 이름 일치·전방 일치·모든 핵심 토큰 이름 포함 (
nameRank 0~3) - 2순위: 검색어 원자 토큰 커버리지 ("분홍"과 "구두" 두 조건을 모두 충족하는 항목이 단일 조건 충족 항목보다 항상 우선)
- 3순위: 부분 이름 일치 및 초성 검색 일치
- 4순위: AI 시각 키워드·오브젝트·색상 태그 일치 개수
- 5순위: AI 외형 상세 설명(
descriptionKo) 매칭 점수 + 정규화된 벡터 시맨틱 가산점(semanticScore) - 6순위: 미세 코사인 유사도 수치 및 이름 길이순 정렬
- 1순위: 정확한 이름 일치·전방 일치·모든 핵심 토큰 이름 포함 (
4. 이 아키텍처의 이점과 기술적 한계, 그리고 현재 시스템에서 최적인 이유
4-1. 핵심 이점 (Advantages)
- 직관적 연상 검색 지원: 아이템 이름을 전혀 기억하지 못해도 눈에 보이는 색상, 사물, 형태, 분위기로 즉시 원하는 코디 피스와 도트 자산을 탐색할 수 있습니다.
- 기존 이름·초성 검색 경험의 완벽한 보존: 시맨틱 검색을 도입할 때 흔히 발생하는 "정확한 이름을 쳤는데 엉뚱한 유사 아이템이 위에 뜨는 문제"를 다계층 스코어링으로 완벽히 해결했습니다.
- 통합 검색과 개별 카테고리 페이지의 100% 정렬 일관성: 통합 아카이브 검색(
/archive)과 14개 개별 카테고리 목록 페이지가 동일한 하이브리드 정렬 함수를 공유하여 어디서 검색하든 일관된 결과를 제공합니다.
4-2. 솔직하게 짚어보는 기술적 한계 (Limitations)
- 초저해상도 도트 스프라이트의 시각적 모호성: 20~30픽셀 크기의 작은 소비·기타 아이템이나 미세한 장신구는 도트 표현 자체가 압축되어 있어, 로컬 Vision LLM이라도 작은 장미 문양을 리본이나 보석으로 해석하는 등 시각적 모호성이 발생할 수 있습니다.
- 정적 프레임 기반 분석의 한계: 데미지 스킨이나 화려한 이펙트 의자처럼 시간에 따라 변화하는 애니메이션 자산은 대표 합성 프레임을 기준으로 분석되므로, 움직임의 속도감이나 프레임 간 전환 연출까지는 텍스트에 모두 담기 어렵습니다.
- 2단계 파이프라인의 오차 전파: 1단계 Vision LLM이 특정 사물의 명칭을 다르게 태깅하면 2단계 텍스트 임베딩 역시 해당 기술어를 바탕으로 벡터를 생성하므로, 프롬프트와 정규화 규칙의 지속적인 품질 관리가 중요합니다.
4-3. 그럼에도 지금 너공마 시스템에서 이 구조가 '최적해'인 이유
수백 명이 동시에 접속해 아카이브를 탐색하고 코디를 시뮬레이션하는 웹 서비스에서는 검색 응답 속도(Latency), 인프라 복잡도, 검색 정밀도(Precision), 운영 비용의 균형이 가장 중요합니다. 약 7.1만 건이라는 도메인 특화 카탈로그 규모에서는 무거운 외부 분산 벡터 데이터베이스 클러스터를 별도로 운영하는 것보다, 오프라인에서 로컬 LLM으로 고품질 한국어 시각 메타데이터와 1024차원 벡터를 정밀하게 생성해 두고, 온라인 웹 서버에서는 73MB의 Int8 양자화 TypedArray 색인과 한국어 복합어 분석기를 결합해 수 밀리초 만에 처리하는 구조가 속도·정확도·안정성 모든 면에서 가장 이상적인 아키텍처입니다.
5. 대규모 AI 인식 및 추론 비용을 절약한 6가지 엔지니어링 기법
71,235건의 멀티모달 이미지 분석과 임베딩 생성을 외부 상용 클라우드 Vision API로 처리하고 매번 재분석했다면 상당한 API 과금 비용이 지속적으로 발생했을 것입니다. 너공마는 다음 6가지 기법으로 외부 API 과금 비용 0원과 최소한의 연산 자원 소모를 달성했습니다.
- 100% 자체 로컬 추론 인프라와 MoE 모델 활용: 전체 파라미터는 26B이지만 토큰당 활성화 파라미터는 4B인 Gemma-4-26B-A4B(MoE) 모델과 BGE-M3를 자체 로컬 환경에서 구동하여, 26B급 시각 이해력을 유지하면서도 추론 속도와 전력·VRAM 효율을 극대화하고 상용 API 토큰 비용을 완전히 제거했습니다.
- 추론 토큰 오버헤드 최소화(Zero Reasoning Overhead): 시각 태깅은 복잡한 수학적 추론이 아니라 직관적인 시각 인식 작업입니다.
temperature: 0,reasoning_effort: "none"설정과 축약된 한국어 전용 JSON 스키마를 적용해 불필요한 내부 추론(Chain-of-Thought) 토큰 생성을 끄고 아이템당 생성 토큰 수를 최소화했습니다. - SHA-256 이미지 바이트 해시 및 중복 외형 식별: 실제 71,235건의 아카이브 자산을 전수 조사한 결과, 성별 공유 아이템·이벤트 복각 아이템·동일 아이콘 소비 아이템 등으로 인해 고유 이미지 SHA-256 해시는 45,061건(약 36.7%가 동일 스프라이트 공유)임을 확인했습니다. 모든 분석 레코드에 원본 이미지 해시(
sourceImageHash)를 기록하여 패치 이후 이미지가 실제로 변경된 자산만 식별할 수 있는 기반을 마련했습니다. - PostgreSQL 직렬화 잠금 및 증분 큐잉(
SKIP LOCKED): 신규 패치로 아이템이 추가될 때 전체를 다시 돌리지 않고, 아직 시각 분석이 없는 항목만 우선순위(장비 → 의자 → 라이딩 → 데미지 스킨 순)에 따라 선별 등록합니다. 워커는FOR UPDATE SKIP LOCKED와 하트비트 감시를 통해 중복 연산 없이 안전하게 배치 처리합니다. - 시각 분석(VLM)과 텍스트 임베딩(BGE-M3)의 디커플링: 검색 품질 개선을 위해 임베딩 텍스트 조합 규칙만 변경할 때는 비용이 큰 Vision LLM 이미지 분석을 다시 수행하지 않고, DB에 저장된 한국어 시각 태그만으로 1024차원 텍스트 임베딩만 빠르게 재계산(Backfill)합니다.
- 실시간 질의 임베딩의 3중 방어선 (사전 필터링 + LRU 캐시 + In-Flight 병합 + 1.5초 타임아웃):
- 1글자 검색어, 숫자 ID 검색, 초성 검색(예:
"ㅂㅎㄱㄷ")은 임베딩 모델을 호출하지 않고 즉시 어휘 엔진으로만 처리합니다. - 자주 검색되는 자연어 질의는 30분 TTL의 인메모리 LRU 캐시(300개)에 양자화된 Int8 벡터 상태로 보관하여 재호출을 방지합니다.
- 동시에 여러 모험가가 같은 검색어를 입력하면 In-Flight Promise 병합으로 단 1번만 임베딩을 요청하며, 만약 로컬 AI 서버가 배치 작업 중이라 1.5초 이내에 응답하지 않으면 즉시 타임아웃 폴백이 작동해 어휘·태그 검색 결과를 지연 없이 반환합니다.
- 1글자 검색어, 숫자 ID 검색, 초성 검색(예:
직접 경험해 보기: 지금 너공마 통합 아카이브(/archive) 또는 각 아이템 카테고리 검색창에서 정확한 아이템 이름 대신 "분홍 구두", "보라색 날개", "초승달 의자", "푸른 불꽃"처럼 떠오르는 외형과 색상으로 검색해 보세요.